Базовое SEO для интернет-магазина: что я проверяю в первую очередь
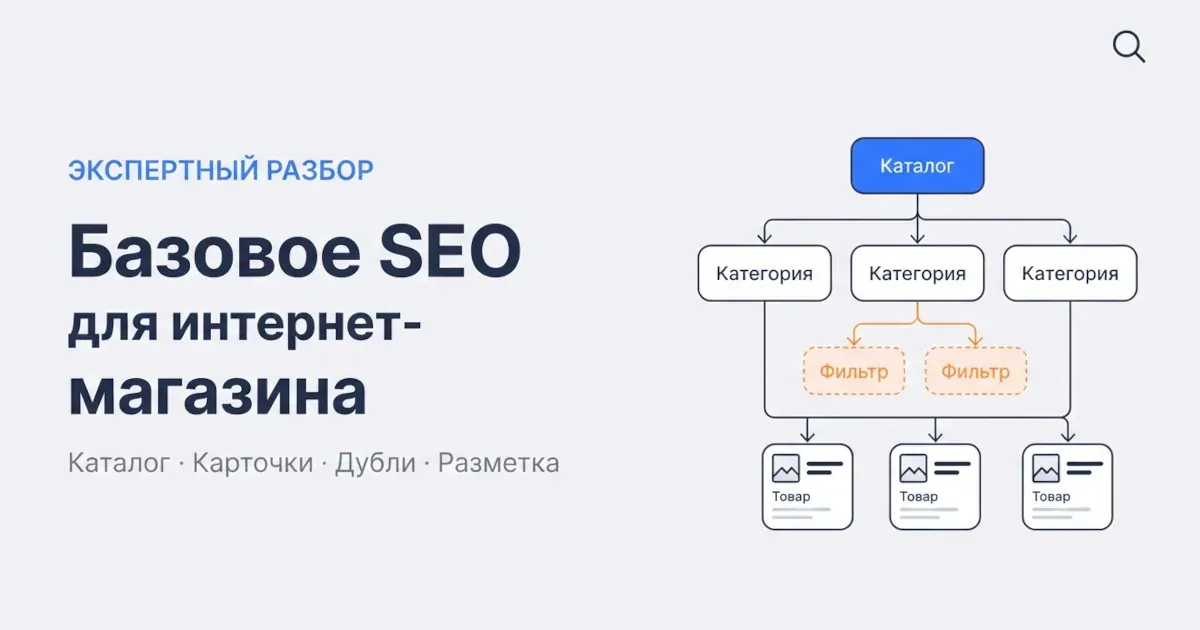
Когда ко мне приходит интернет-магазин «посмотреть, почему нет трафика», в 80% случаев причина не в ссылках и не в «слабом контенте». Дело в базовой архитектуре: каталог собран как удобнее программисту, фильтры плодят тысячи дублей, а карточки закончившихся товаров отдают 404 прямо из топа.
Ниже мой стандартный чек-ап по пяти блокам, с примерами и с тем, на какие грабли я уже наступал.
1. Структура каталога и категорий
Каталог строится от спроса, а не от склада
Самая частая ошибка: структуру рисует владелец бизнеса по складской номенклатуре («Крепёж → Метизы → Группа 3 → Подгруппа Б»). Поисковые запросы так не устроены. Люди ищут «саморезы по металлу», а не «метизы, группа 3».
Мой порядок работы такой:
- Собираю семантику по коммерческим запросам (Wordstat, Keys.so, Topvisor, Google Keyword Planner).
- Кластеризую запросы: один кластер, одна посадочная страница.
- Раскладываю кластеры по уровням: раздел → категория → подкатегория.
- Только после этого сверяю с реальным ассортиментом.
Базовые правила
- Глубина до товара не больше 3–4 кликов от главной. Глубже не страшно для индексации, но ссылочный вес и внимание краулера размазываются.
- Одна категория, один интент. Если «Кроссовки мужские» и «Мужская обувь для бега» ведут на разные страницы, а запросы по сути одни, вы получаете каннибализацию.
- Не создавайте категории «на вырост». Пустая или с двумя товарами категория — это тонкий контент.
- Хлебные крошки обязательны, причём в разметке
BreadcrumbList, а не только визуально.
URL: плоско или вложенно?
Я за вложенные URL для категорий и плоские для товаров:
/catalog/krossovki/muzhskie/          ← категория
/product/nike-air-zoom-pegasus-40/    ← товар
Почему плоско для товаров: один товар часто лежит в нескольких категориях. Если зашить категорию в URL товара, получаются дубли: /catalog/a/product-1/ и /catalog/b/product-1/. Если же движок так делает принудительно, нужен rel="canonical" на основной URL товара.
Внутренняя перелинковка
- Меню и плитки подкатегорий внутри категории (обычные
<a href>, а не JS-обработчики). - Блок «Похожие товары» и «С этим покупают» в карточке.
- Ссылки из текстов категорий на смежные разделы.
Пагинация
Здесь много мифов, поэтому коротко:
- Google давно не использует
rel="prev/next". Яндекс тоже на них не опирается. Можно оставить, вреда нет, пользы почти нет. - Каждая страница пагинации получает self-canonical (страница 2 канонична сама себе). Не ставьте canonical всех страниц на первую: так товары со страниц 2+ могут выпасть из индекса.
- В
<title>и<h1>страниц 2+ добавляйте номер страницы, а SEO-текст показывайте только на первой. - Ссылки на страницы пагинации должны быть обычными ссылками, без «подгрузки по скроллу» без fallback.

2. Оптимизация карточек товаров
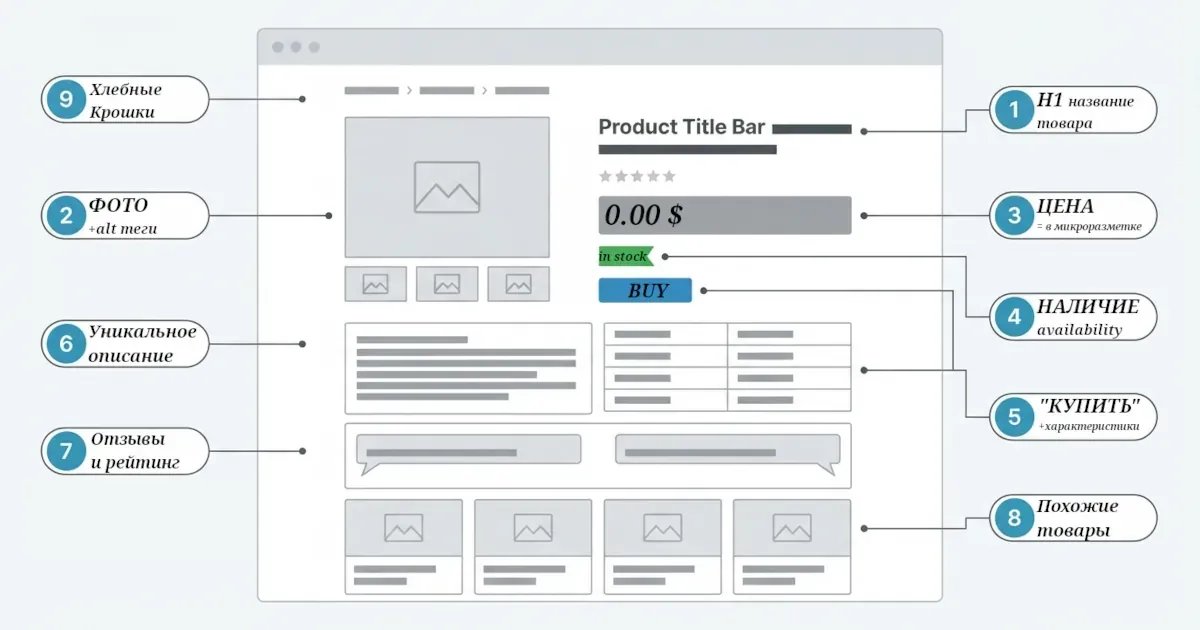
Карточка — это страница, которая приносит деньги. Но в магазине на 20 000 SKU вручную оптимизировать всё нереально. Поэтому делю работу на шаблоны и ручную доработку топовых позиций.
Title, H1, description: шаблонная генерация
Рабочий шаблон для title:
{Название товара} — купить в {Город} по цене от {Цена} ₽ | {Бренд магазина}Для description:
{Название товара}: {2–3 ключевые характеристики}. ✔ В наличии ✔ Доставка по {региону} ✔ Гарантия. Заказывайте на {домен}.Что здесь важно:
- Название товара должно содержать тип товара + бренд + модель, а не только артикул.
- Не пихайте в title всё подряд. Читаемость важнее ключей.
- Если в шаблоне есть переменная, которая у части товаров пустая (цена, бренд), нужны условия-fallback, иначе в выдаче будут «купить по цене от ₽».
Описание: уникальность против реальности
Идеальный мир: на каждый товар уникальное описание. Реальный мир: поставщик отдаёт одинаковый текст всем магазинам.
Мой компромисс:
- Топ-10–20% товаров по спросу и марже получают уникальные описания (я пишу структуру, копирайтер или нейросеть с ручной вычиткой пишет текст).
- Остальным добавляю уникализирующие блоки: характеристики в читаемом виде, блок «Кому подойдёт», блок с условиями доставки и гарантии, FAQ по товарной группе.
- Копипаст от поставщика в чистом виде оставляю только на хвосте ассортимента и слежу, чтобы такие страницы не раздували индекс.
Изображения
altописывает содержимое: «Кроссовки Nike Pegasus 40, вид сбоку», а не «image1» и не набор ключей.- Форматы WebP/AVIF, адаптивные
srcset. - Первое изображение (оно часто LCP) не отдаём через
loading="lazy". Остальные можно. - Имена файлов человекочитаемые:
nike-pegasus-40-black.webp.
Варианты товара (цвет, размер)
Две стратегии:
- Один URL, переключатель вариантов (размер/цвет внутри карточки). Подходит, когда по запросам цвет и размер не ищут отдельно.
- Отдельные URL на варианты с canonical на основной. Если вы хотите ловить запросы вроде «iPhone 15 Pro 256 синий», вариант должен быть индексируемой страницей со своим title и самоканоническим URL.
Худший вариант — отдельные URL для вариантов с одинаковым контентом и без canonical.
Скорость и юзабилити
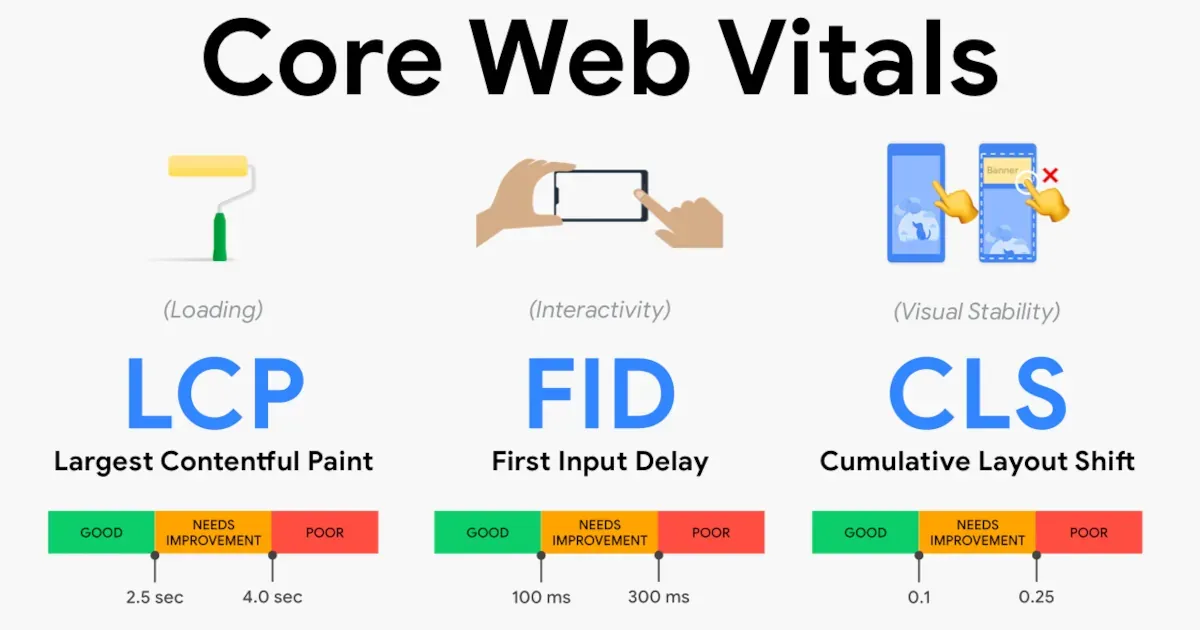
Core Web Vitals в карточке упираются почти всегда в картинки, тяжёлые скрипты виджетов (чаты, отзывы, рекомендации) и CLS от «прыгающих» блоков. Проверяйте через PageSpeed Insights и Search Console (отчёт Core Web Vitals).
3. Проблема дублей от фильтров и сортировок
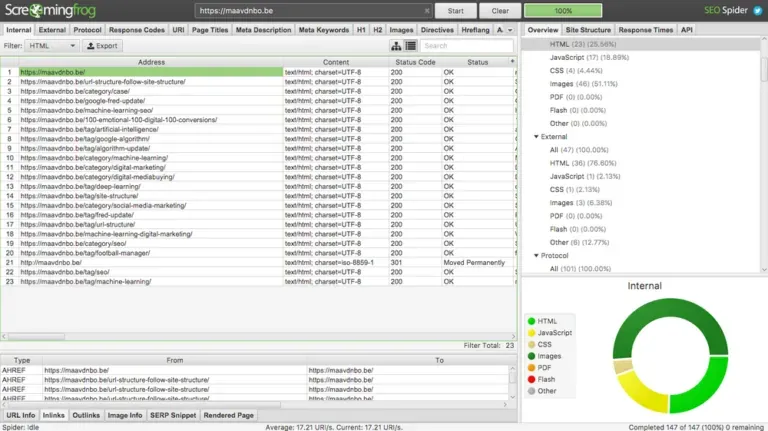
Это главный убийца индексации в магазинах. Три фильтра по пять значений, плюс сортировка, плюс пагинация — и вот у вас из 200 категорий получается миллион URL. Краулер тратит бюджет на мусор, а нужные страницы переобходятся раз в месяц.
Шаг 1. Делим все фильтрованные URL на два класса
| Класс | Пример | Что делаем |
|---|---|---|
| Есть спрос | «кроссовки nike мужские», «диван угловой серый» | Делаем полноценной индексируемой посадочной |
| Спроса нет | сортировка по цене, фильтр по 3 параметрам сразу, «в наличии» | Закрываем от индексации |
Решение принимаю по данным: частотность в Wordstat/Keys.so и наличие реальных товаров в выборке.
Шаг 2. Страницы с реальным спросом — делаем landing’ами
Для комбинаций вида «категория + бренд», «категория + цвет», «категория + материал» я делаю ЧПУ-страницы вместо параметров:
/catalog/krossovki/nike/ вместо /catalog/krossovki/?brand=nikeУ такой страницы должны быть:
- уникальные title, H1, description (шаблон + подстановка значения фильтра);
- самоканонический URL;
- присутствие в sitemap.xml;
- внутренние ссылки (блок «Популярные подборки» в категории).
Если страница с фильтром выдаёт 0 товаров, она должна отдавать 404 или хотя бы noindex. Пустые «подборки» — классический мусор.
Шаг 3. Всё остальное закрываем
Какие инструменты у нас есть и в чём их разница:
| Инструмент | Что делает | Когда использовать |
|---|---|---|
rel="canonical" |
Подсказывает, какой URL основной | Сортировки, пагинация внутри фильтров, UTM |
<meta name="robots" content="noindex, follow"> |
Не даёт индексировать, но разрешает ходить по ссылкам | Фильтры без спроса, которые уже попали в индекс |
robots.txt Disallow |
Запрещает сканирование | Когда нужно сэкономить краулинговый бюджет |
Clean-param (Яндекс) |
Говорит роботу, что параметр не влияет на контент | Сортировки, utm, сессии |
| JS/POST-фильтры | Не создают новых URL вообще | Фильтры, которые не должны попадать в индекс по определению |
Важная ловушка, на которую я натыкался не раз. Если вы закрыли URL в robots.txt, робот не зайдёт и не увидит ни noindex, ни canonical. Если страницы уже в индексе, сначала ставим noindex и ждём, пока они выпадут, и только потом закрываем в robots. Иначе получится «зомби-индекс»: URL в выдаче есть, а содержимое робот прочитать не может.
Пример для robots.txt:
User-agent: *
Disallow: /*?sort=
Disallow: /*?view=
Disallow: /*&sort=
Disallow: /*?utm_

User-agent: Yandex
Clean-param: sort&view&utm_source&utm_medium&utm_campaign /catalog/
Про отдельный инструмент «Параметры URL» в Search Console можно забыть: Google его отключил в 2022 году, теперь работаем только canonical, noindex и robots.
Шаг 4. Мониторим
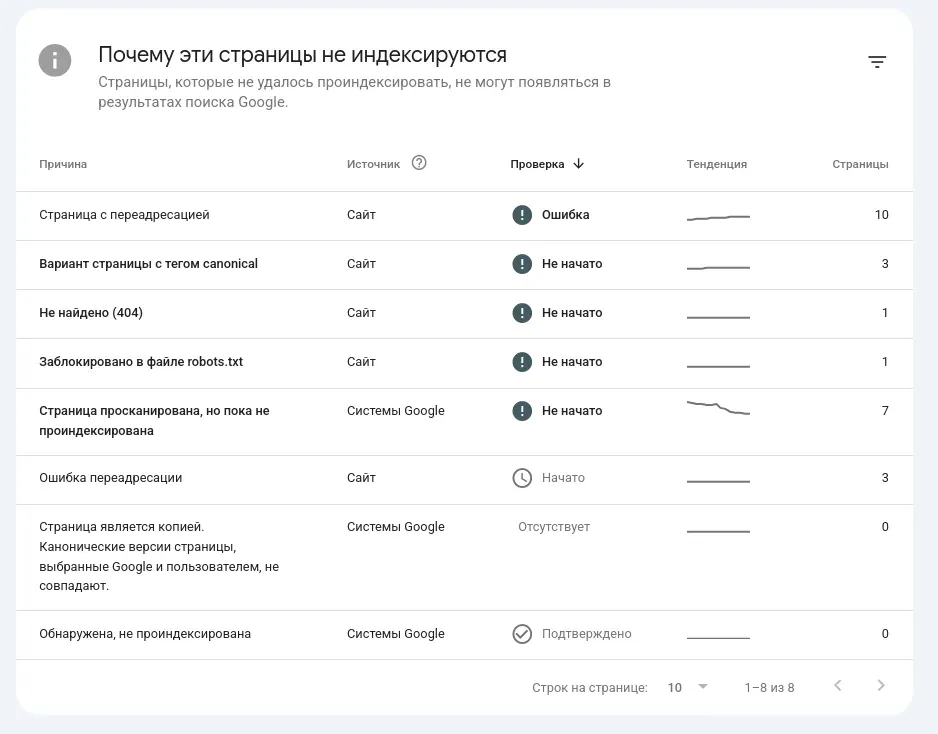
- Search Console → Страницы: смотрим причины «Страница является копией» и «Просканировано, но пока не проиндексировано».
- Яндекс Вебмастер → Индексирование → Страницы в поиске / Исключённые страницы.
- Серверные логи: лучший способ увидеть, на что реально уходит краулинговый бюджет.
4. Обработка страниц закончившихся товаров
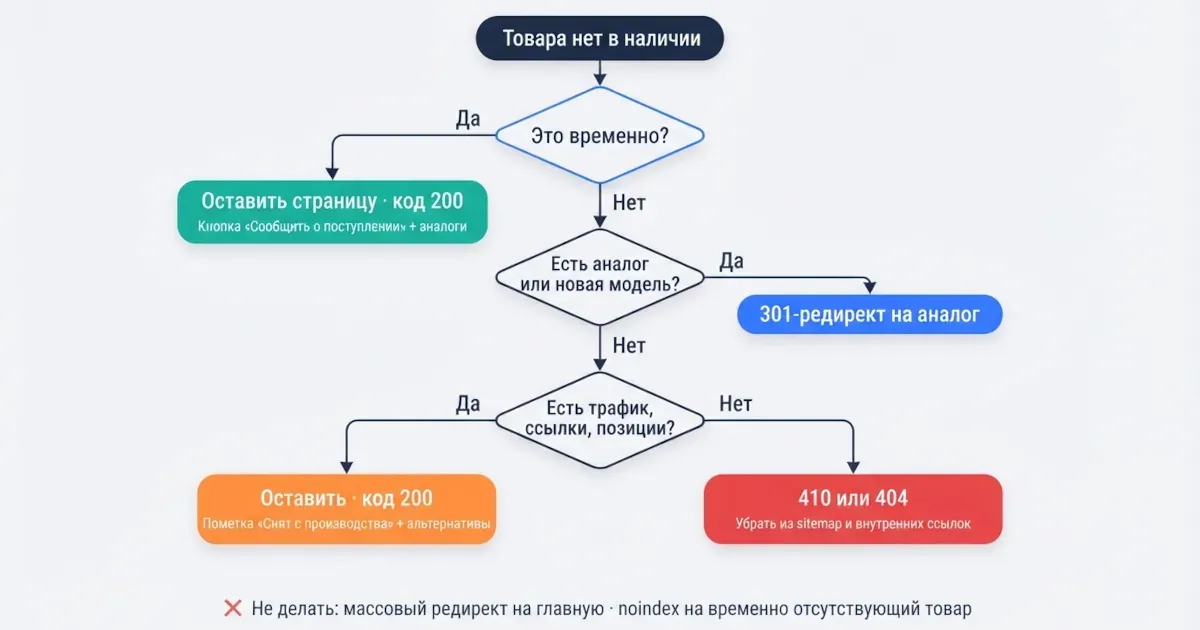
Тут нет универсального рецепта. Правильный ответ зависит от того, почему товара нет. Вот моя схема.
Случай 1. Товара нет временно (ждём поставку)
Оставляем страницу как есть, код ответа 200.
На странице:
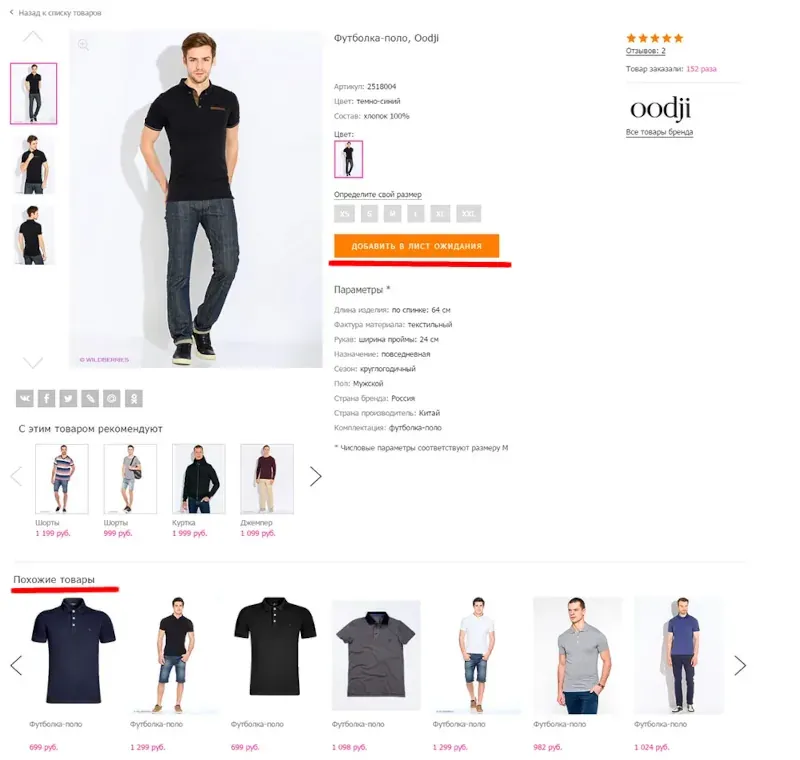
- чётко пишем «Нет в наличии» или «Ожидается поступление»;
- кнопка «Сообщить о поступлении» (это ещё и лидогенерация);
- блок аналогов и похожих товаров;
- в микроразметке
availabilityставимhttps://schema.org/OutOfStock(илиPreOrder/BackOrder, если это соответствует действительности).
Позицию в категории опускаем в конец списка, но не удаляем.
Случай 2. Товар снят с производства / больше не будет
Тут смотрим, есть ли у страницы ценность (трафик, ссылки, позиции).
- Есть прямой аналог или новая модель: 301-редирект на него. Редирект должен быть релевантным: содержимое страницы-цели должно отвечать тому же запросу.
- Аналога нет, но страница ценна: оставляем с 200, пишем «Снят с производства», выводим альтернативы. Такая страница ещё долго работает как посадочная для информационного трафика и перелинковки.
- Ценности нет: отдаём 410 Gone (или 404) и убираем из sitemap и внутренних ссылок.
Чего делать нельзя
- Массово редиректить на главную. Google трактует такие редиректы как soft 404, а пользователь теряется.
- Отдавать 200 на пустую страницу без информации («Товар не найден» с кодом 200). Это тот же soft 404.
- Ставить
noindexна временно отсутствующий товар. Он вернётся, а индексацию придётся отвоёвывать заново. - Оставлять в sitemap URL, которые отдают 404/301. Sitemap должен содержать только каноничные 200-страницы.
Автоматизация
Если ассортимент большой, логику надо вшить в CMS/выгрузку: срок «нет в наличии» больше N дней → условие на переклассификацию. Я обычно договариваюсь с разработчиками на три статуса: in_stock, temporarily_out, discontinued. На каждый статус своя логика отдачи.
5. Отзывы и микроразметка товаров и рейтингов
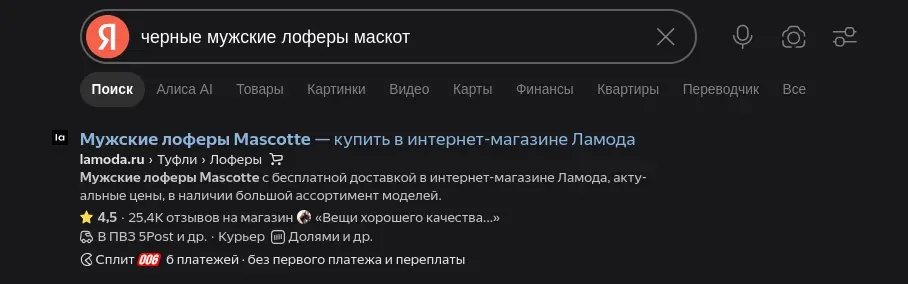
Звёзды и цена в сниппете заметно поднимают CTR, особенно в конкурентных нишах. Но разметка — не волшебная кнопка: нарушения правил приводят к ручным мерам, а то и просто к игнорированию.
Минимальный рабочий набор: Product + Offer
Я использую JSON-LD, поскольку его проще поддерживать и валидировать:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Кроссовки Nike Air Zoom Pegasus 40",
  "image": [
    "https://example.ru/images/nike-pegasus-40-1.webp",
    "https://example.ru/images/nike-pegasus-40-2.webp"
  ],
  "description": "Беговые кроссовки с амортизацией React.",
  "sku": "NK-PEG40-BLK-42",
  "brand": { "@type": "Brand", "name": "Nike" },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "reviewCount": "128"
  },
  "offers": {
    "@type": "Offer",
    "url": "https://example.ru/product/nike-air-zoom-pegasus-40/",
    "priceCurrency": "RUB",
    "price": "11990",
    "priceValidUntil": "2026-12-31",
    "availability": "https://schema.org/InStock",
    "itemCondition": "https://schema.org/NewCondition"
  }
}
</script>
Правила, которые я соблюдаю всегда
- Данные в разметке должны совпадать с тем, что видит пользователь. Цена в JSON-LD и цена на странице — одно и то же число. Расхождение — прямой путь к потере расширенных сниппетов.
- Отзывы и рейтинг должны быть видны на странице. Нельзя размечать то, чего нет в HTML.
- Рейтинг считается по реальным отзывам о конкретном товаре. Не по магазину в целом и не накрученный. Использовать отзывы о компании как рейтинг товара — типичное нарушение.
- Не размечайте
AggregateRatingна листингах (категориях), копируя рейтинг одного товара на всю страницу. Для листингов используйтеItemListили вообще не размечайте рейтинги. - Динамические данные (цена, наличие) обновляются синхронно. Если разметка кэшируется отдельно от страницы, получаются рассинхроны.
- Для отдельных отзывов добавляем
Reviewсauthor,datePublished,reviewRatingиreviewBody. Но это опционально, на практикеaggregateRating+ видимые отзывы в большинстве случаев достаточно.
Как собирать отзывы, если их нет
Пустой блок «Отзывов пока нет» не помогает. Что работает:
- письмо клиенту через 5–7 дней после доставки с прямой ссылкой на форму;
- мотивация (небольшой промокод) за честный отзыв, без требования только положительных;
- импорт отзывов с агрегаторов только если это легально и вы можете подтвердить их происхождение. Накрутка и копирование чужих отзывов в разметку рискованны.
Проверка
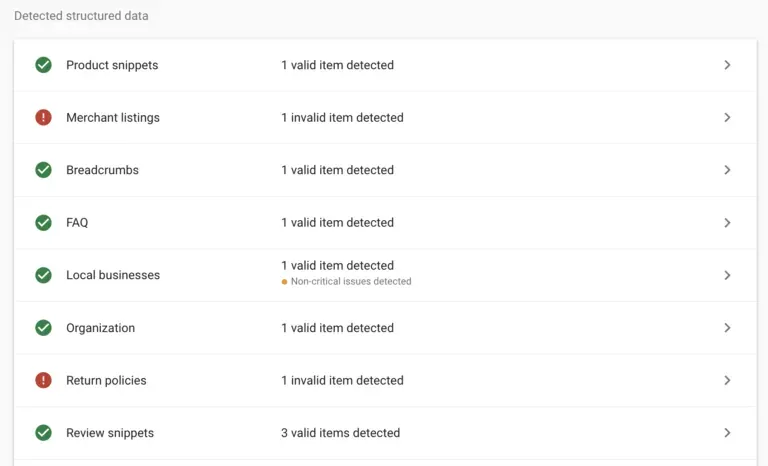
- Google: Rich Results Test и отчёт «Товарные сниппеты» (Merchant listings / Product snippets) в Search Console.
- Яндекс: валидатор микроразметки в Вебмастере. Яндекс понимает schema.org и в целом корректно обрабатывает Product/Offer, но для показа товарных данных стоит параллельно подключить фид (YML) в Яндекс Вебмастере/Яндекс Бизнесе.
Итоговый чек-лист
Структура
- Каталог построен по кластерам запросов, глубина ≤ 3–4 кликов
- Хлебные крошки +
BreadcrumbList - Пагинация со self-canonical, текст только на первой странице
Карточки
- Шаблоны title/description с fallback-условиями
- Уникализирующие блоки на товарах без уникального описания
- Alt у фото, WebP, LCP-картинка без lazy
Дубли
- Фильтры разделены на «со спросом» и «без спроса»
- Для нужных комбинаций есть ЧПУ-посадочные
- Сортировки и параметры закрыты (canonical/noindex/Clean-param)
- Не закрыты в robots те URL, где нужно сначала снять индекс через noindex
Закончившиеся товары
- Три статуса (в наличии / временно нет / снят) и своя логика на каждый
- Никаких массовых редиректов на главную
- В sitemap только 200-страницы
Разметка
- Product + Offer + AggregateRating в JSON-LD
- Данные в разметке совпадают с видимыми на странице
- Проверка в Rich Results Test и валидаторе Яндекса
Вместо заключения
Если у магазина проблемы с трафиком, я не начинаю с покупки ссылок и не переписываю тексты на всём сайте. Сначала краулю сайт, смотрю на количество URL в индексе и сравниваю с реальным числом нужных страниц. Если разрыв в 5–10 раз, то деньги уходят именно сюда, и именно с этого нужно начинать.
Базовое SEO магазина — это дисциплина: структура, шаблоны, контроль дублей и честная разметка. Скучно, зато работает.